 XRAG
← 返回论文主页
XRAG · ICDE 2026 · 中文解读
从组件到编排,
系统评测 RAG
检索增强生成的效果取决于一整条处理链。XRAG 将这条链拆解为可替换的组件与可组合的工作流,在统一数据和评估条件下,帮助研究者看清每一环的作用。
01 / 把效果差异定位到组件
搭建 RAG 系统时,查询改写、检索模型、重排序和生成模型都有多种选择。某个配置的最终答案更好,改进可能来自其中一个组件,也可能来自多个组件的配合。统一实验条件,才能比较这些选择的实际作用。
XRAG 提供开源的模块化代码库,将核心组件组织为四个阶段:
- 检索前:建立语料索引,改写或扩展查询,为检索准备合适的输入。
- 检索:从语料中寻找与问题相关的证据。
- 检索后:对候选内容重新排序,提高送入模型的上下文质量。
- 生成:让语言模型结合检索结果回答问题。
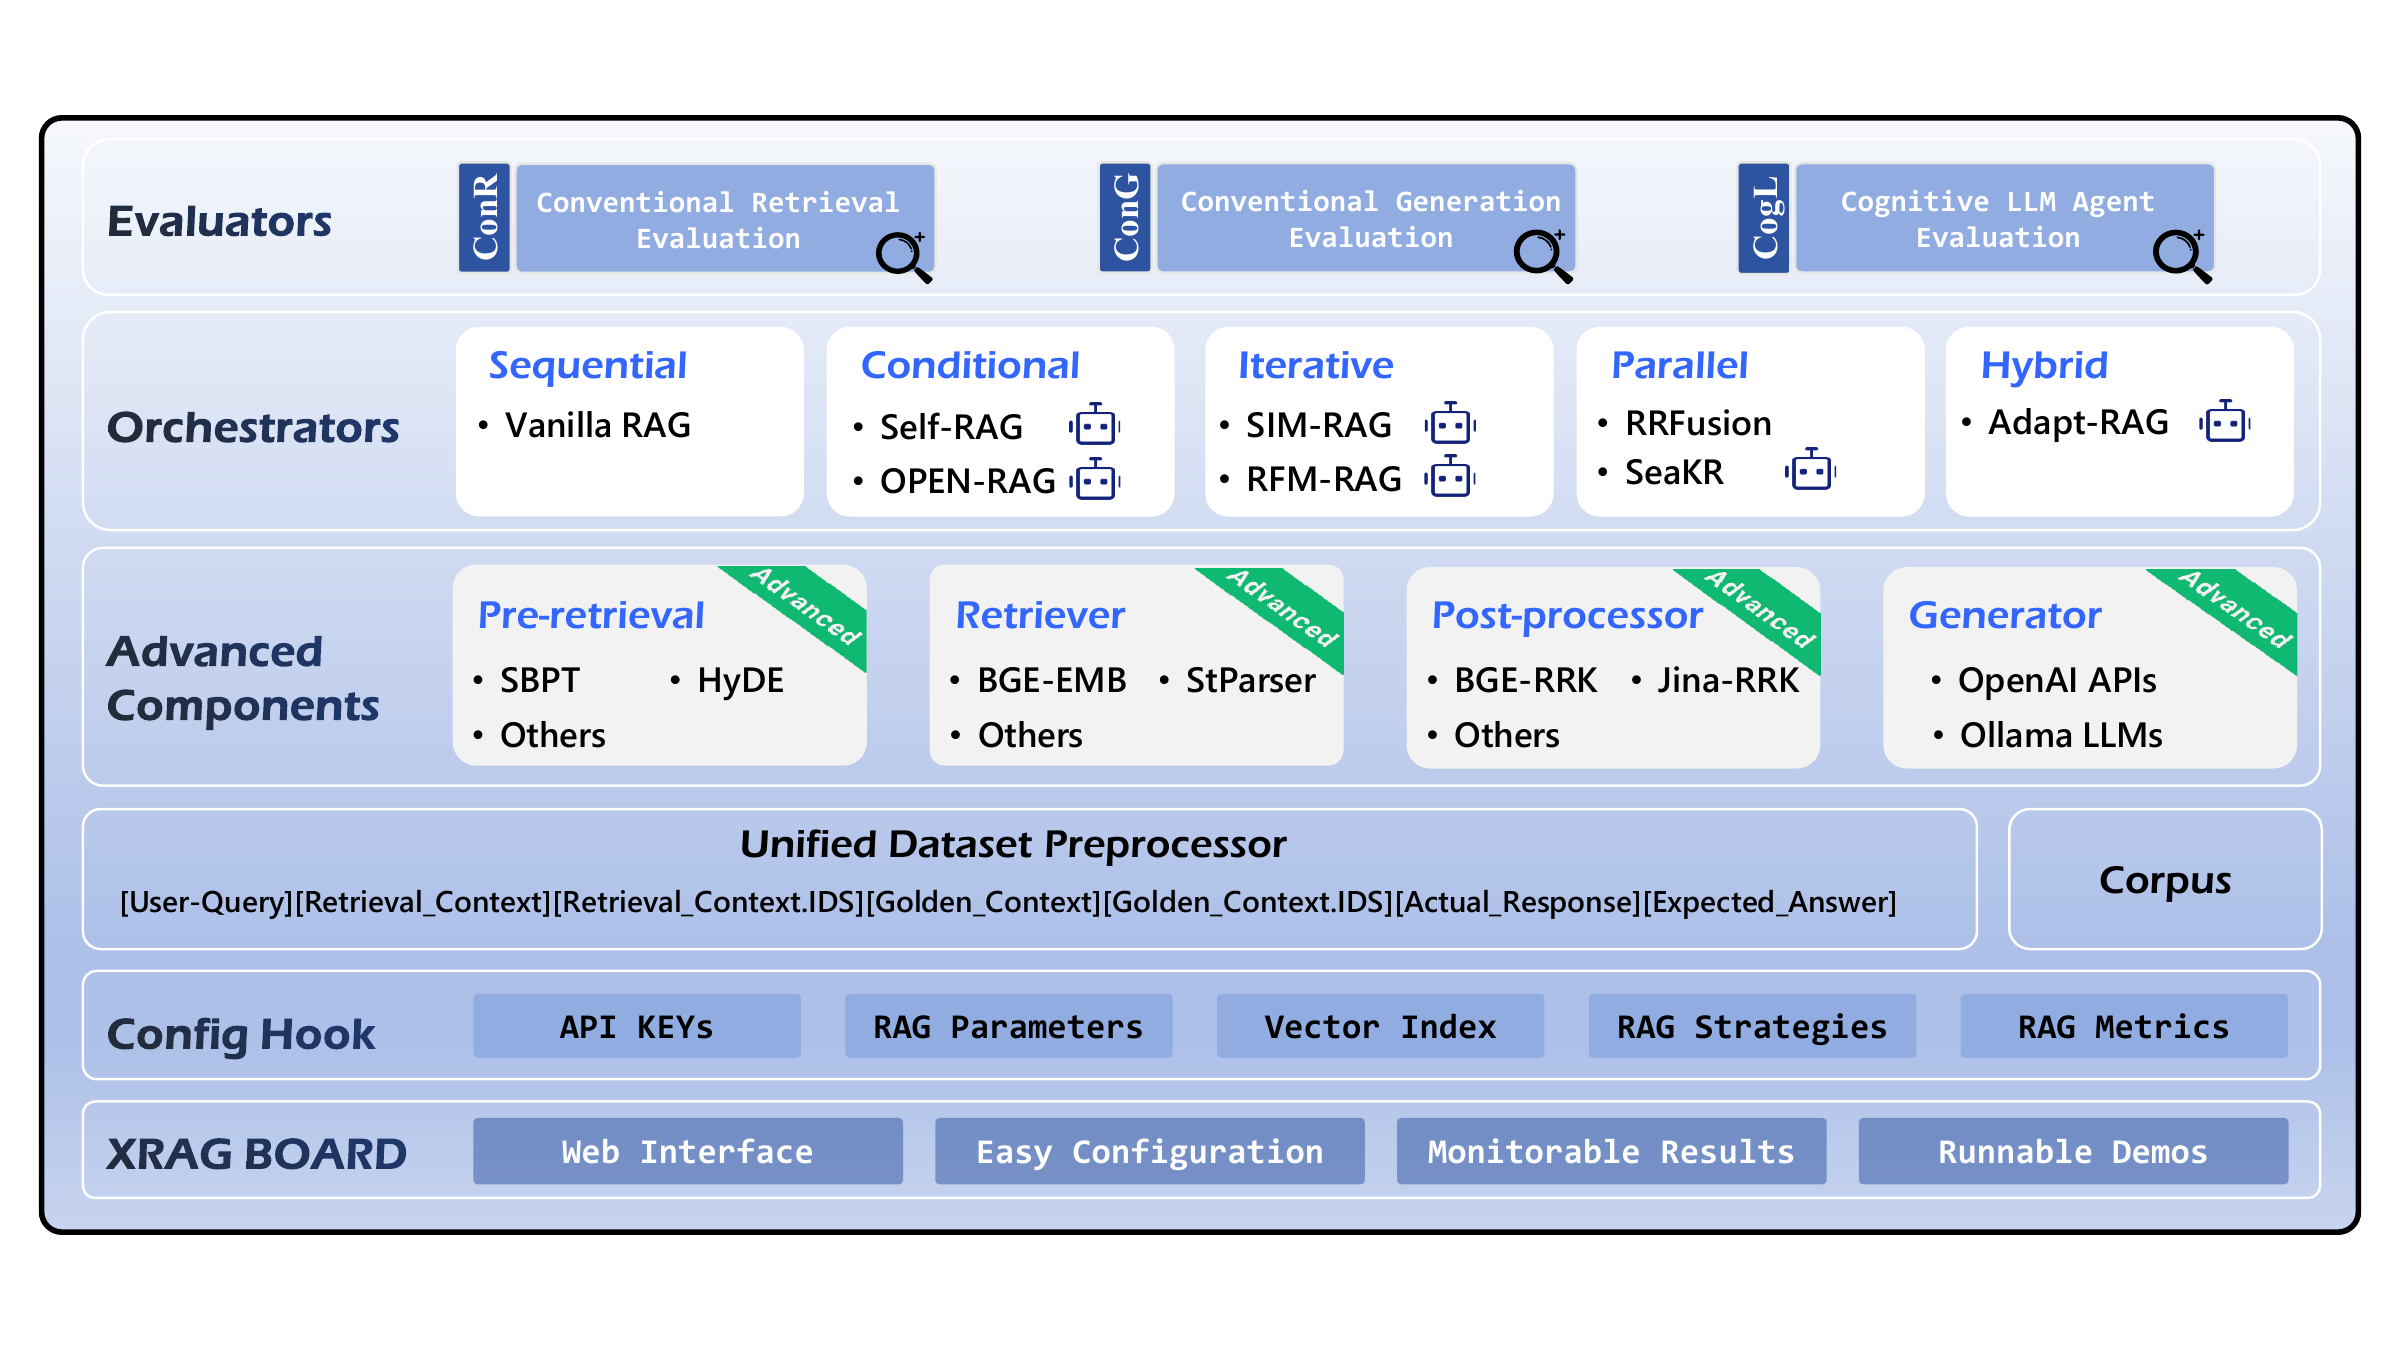
论文覆盖查询改写、不同检索单元、后处理技术以及多个系列的生成模型。模块可以单独替换,便于控制其他条件,分析某项选择带来的变化。
02 / 同一套模块,五种编排方式
模块决定每一步做什么,编排器决定这些步骤何时执行、如何衔接。XRAG 将 RAG 工作流归纳为顺序、条件、迭代、并行和混合五种方式,并在同一框架中进行对比。
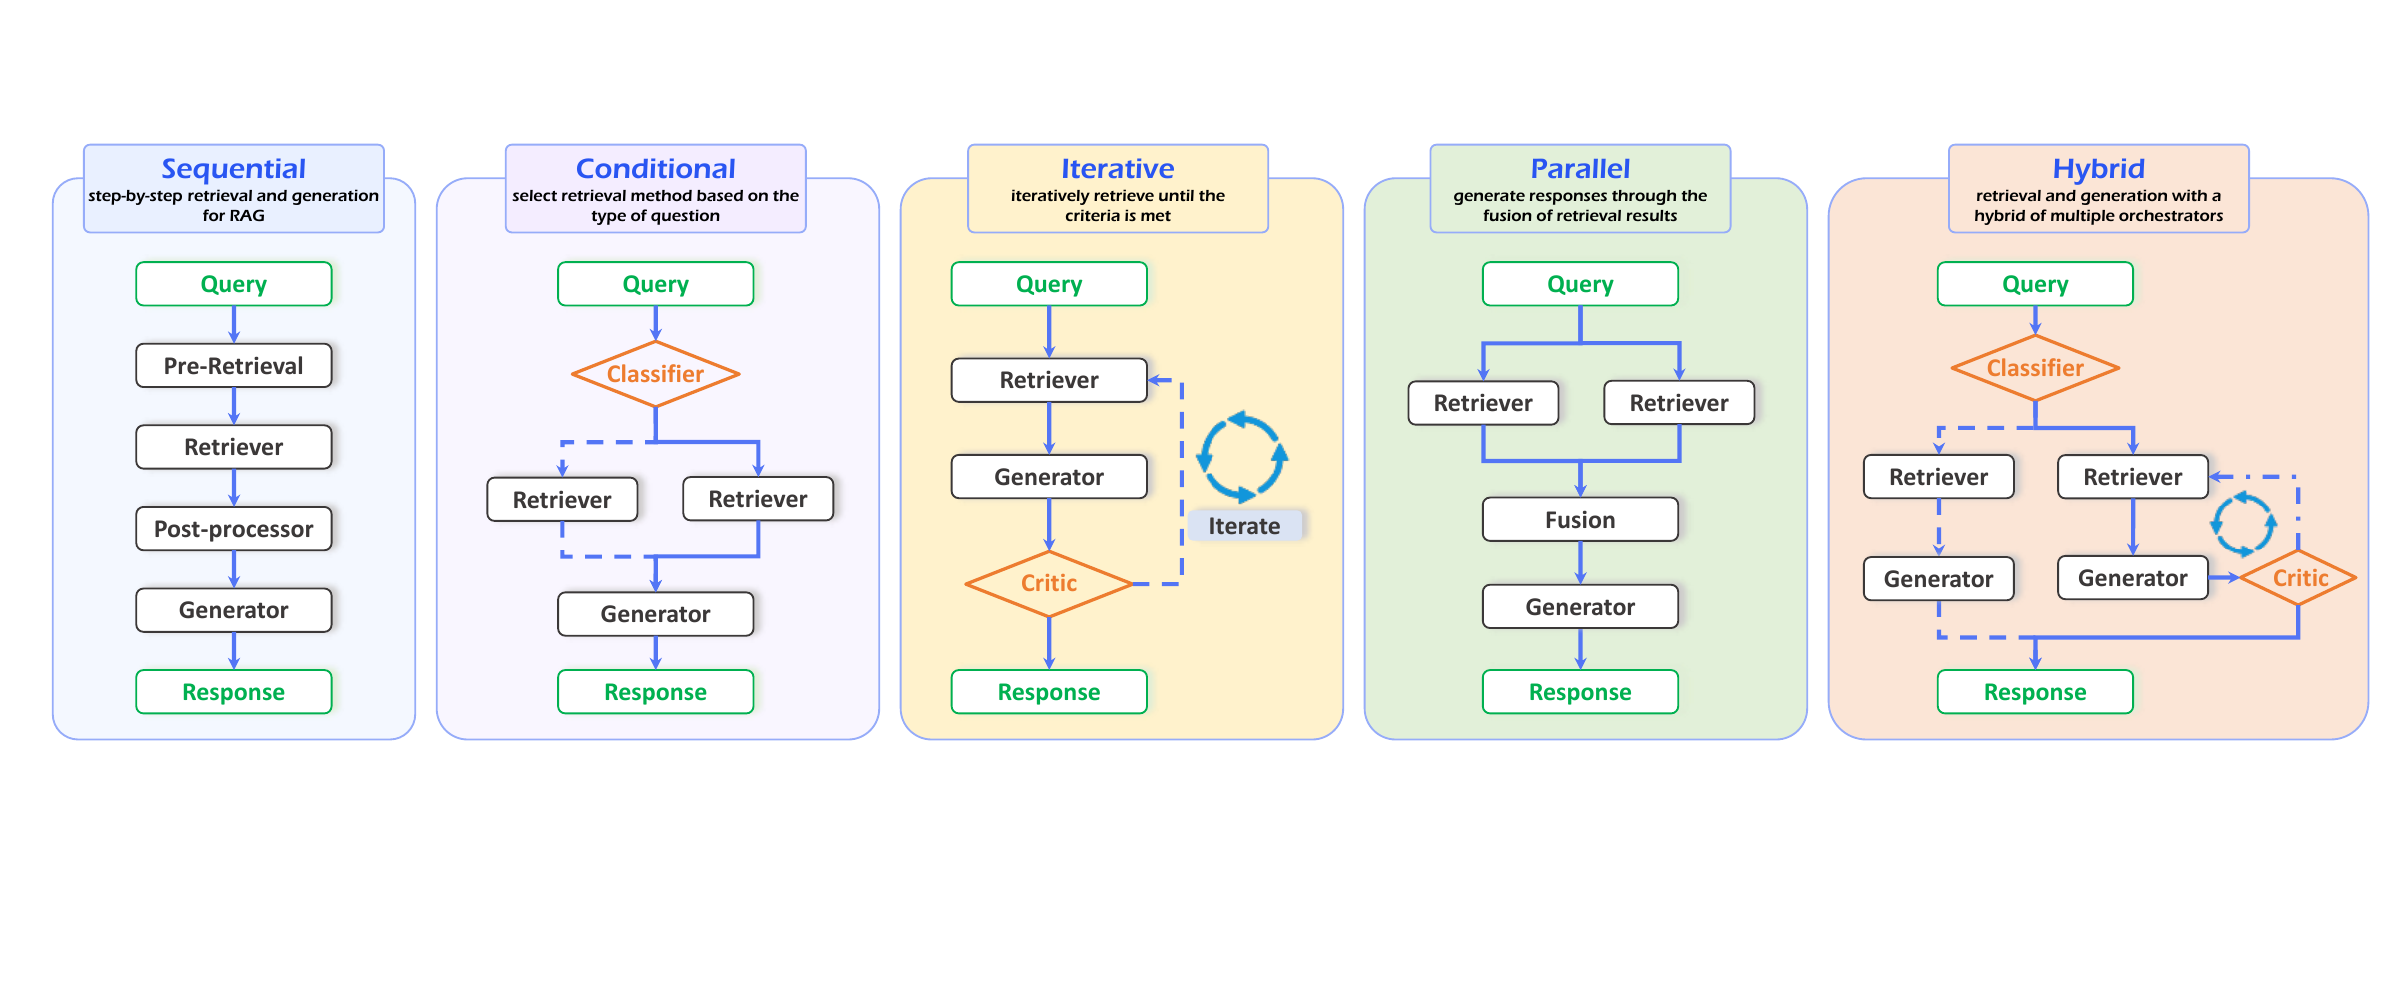
- 顺序:沿固定链路完成检索与生成,适合建立清楚的基线。
- 条件:根据问题或当前状态选择分支,决定是否检索、怎样检索。
- 迭代:多轮获取和补充证据,逐步完善答案。
- 并行:从多个分支获取信息,再融合结果。
- 混合:组合多种控制方式,适应更复杂的问题。
这一区分让研究者能够分别考察“换一个组件”和“换一种执行流程”的收益,并结合具体任务选择适合的结构。
03 / 同时检查证据与答案
XRAG 将 HotpotQA、DropQA、NaturalQA 和 FinanceBench 整理为统一数据格式,关联问题、检索上下文、标准证据、模型回答与参考答案。四个数据集覆盖多跳问答、离散推理、开放域问答和金融问答。
评估由三类视角、40 项统一指标构成,分别回答不同的问题:
| 评估视角 | 主要关注 | 代表指标或维度 |
|---|---|---|
| ConR · 检索评估 | 相关证据是否被找到、排在什么位置 | F1、MRR、Hit@1、MAP、NDCG |
| ConG · 生成评估 | 生成答案与参考答案的文本匹配程度 | ChrF、METEOR、ROUGE 等 |
| CogL · LLM 评估 | 从语义层面检查证据和回答 | 相关性、正确性、忠实性等 |
联合观察这些指标,可以区分检索遗漏、证据使用不充分和生成偏差,也能发现不同指标对同一回答的评价差异。
04 / 难题更依赖检索到的证据
在 HotpotQA 困难子集上,论文按首位检索结果是否命中标准证据,对生成质量进行分组分析。使用 GPT-4o-mini 时,Hit@1 命中组的 ChrF++ 均值为 0.28,未命中组为 0.14。
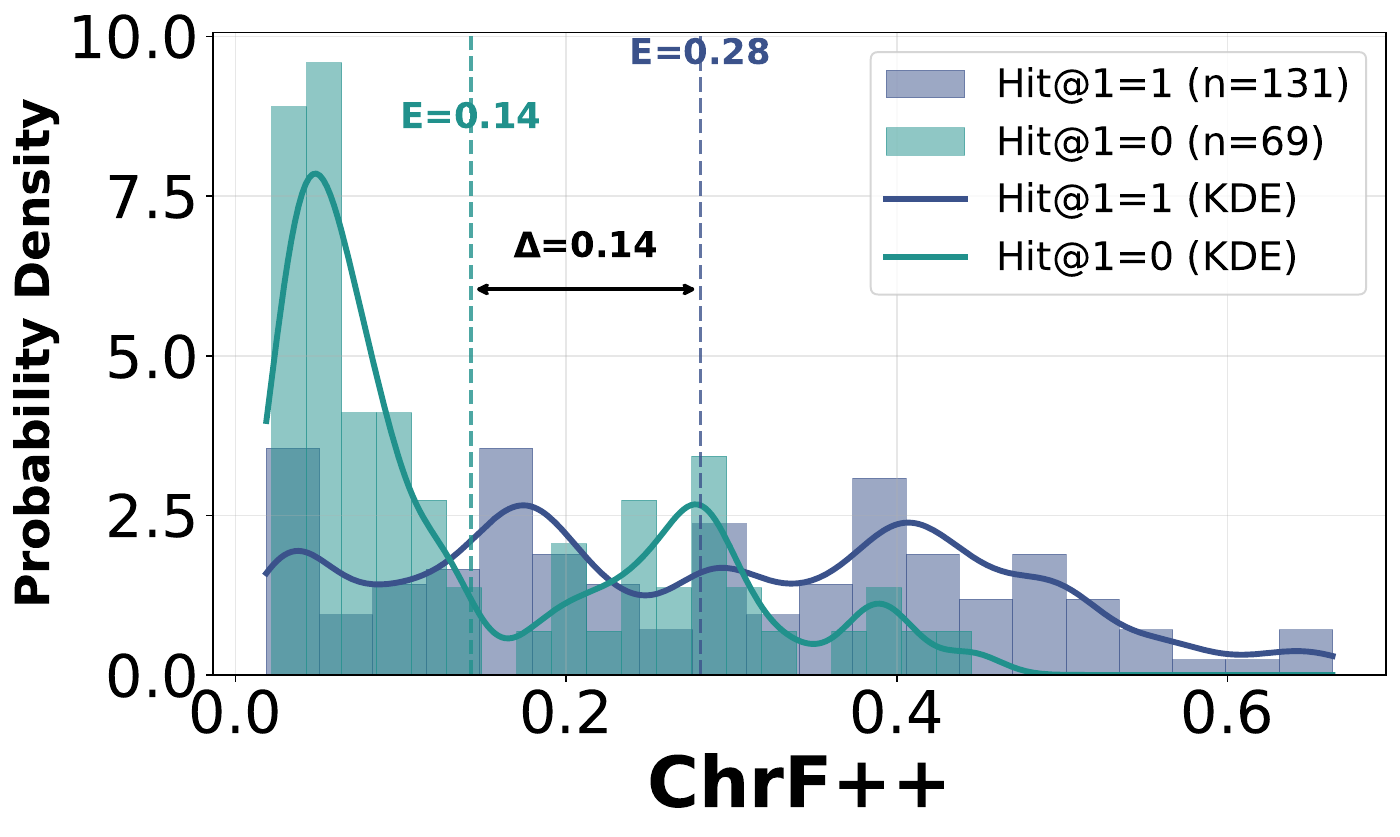
这一结果支持优先提高证据相关性和排序质量。与此同时,命中证据的样本中仍有低质量答案,因此评估还需要继续追踪模型是否正确使用了证据。论文对上下文数量的分析也表明,增加检索条数带来的收益有限,证据质量是更直接的优化目标。
05 / 让工作流适配任务与预算
在多跳问答中,迭代检索可以逐步补齐推理所需的信息。论文表 XI 在统一的 DeepSeek-R1-Distill-Llama-70B 生成模型下比较编排器:HotpotQA 上,顺序基线的 METEOR 为 31.08,SIM-RAG 达到 52.39。
进一步分析迭代轮数时,论文将 SIM-RAG 的最大轮数设为 5。在困难子集中,有 52 个问题达到了这个上限。达到上限的问题仍可能难以回答,更多轮次本身并不保证更好的答案。
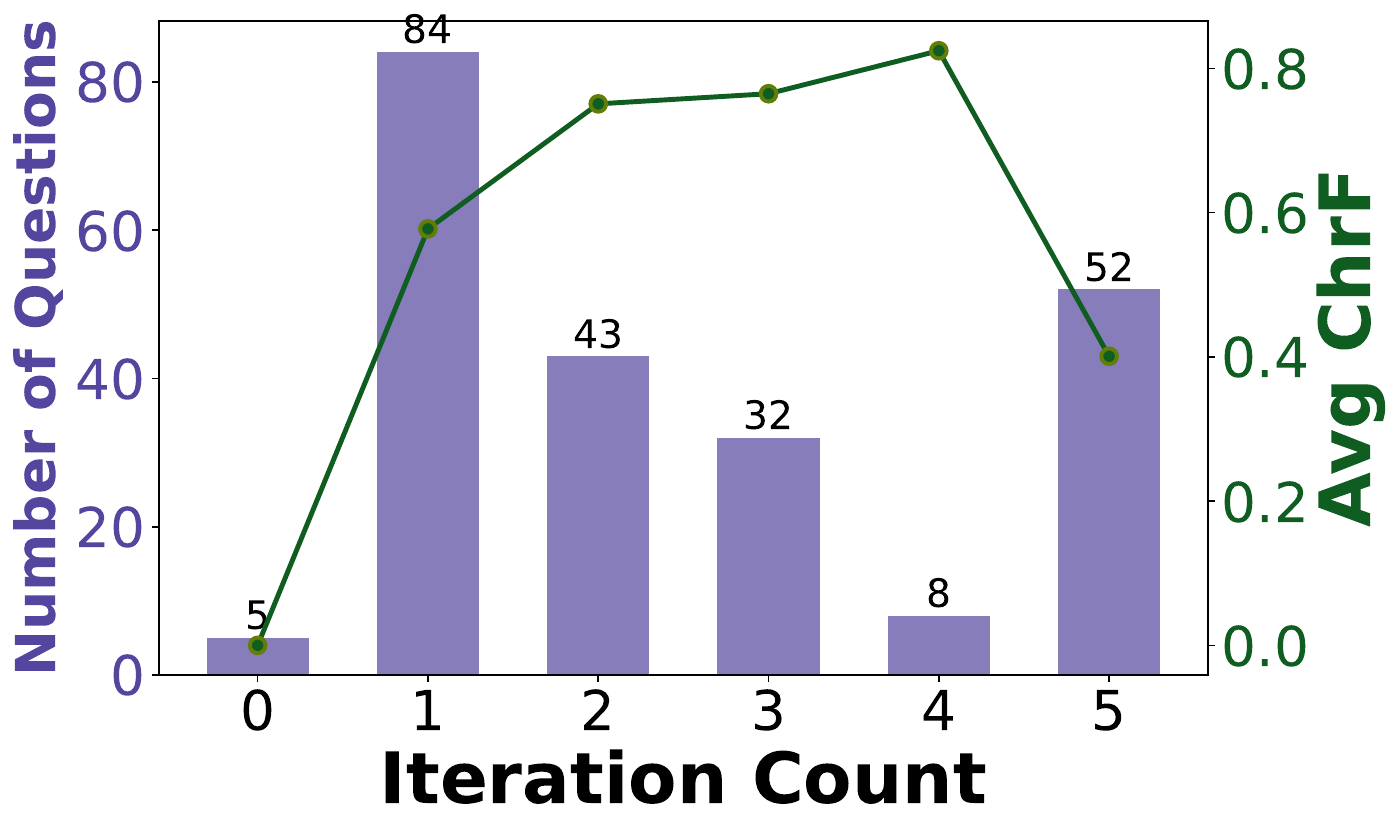
XRAG 还记录各阶段延时与总 token 消耗,使效果评估与运行成本可以一起比较。论文的实验分析显示,重排序在多个数据集上取得稳定收益;复杂编排则需要结合任务难度和延时预算选择。
06 / 从自己的数据开始比较
XRAG 提供代码、配置接口和 Web UI,支持组装流程并查看评估结果。把它用于新任务时,可以先建立固定的顺序基线,再依次比较检索器、后处理与编排方式,结合检索质量、答案表现和运行成本选取配置。
项目的安装和使用方式见 GitHub 仓库 ↗。完整实验设置、结果和分析见论文,公众号文章提供另一种阅读入口。